هوش مصنوعی محلی n8n روی NVIDIA DGX Spark بدون API ابری
n8n اجرای هوش مصنوعی محلی روی NVIDIA DGX Spark را شرح داد؛ راهکاری برای پردازش اسناد، تماسها و پاسخها بدون ارسال داده به API ابری.
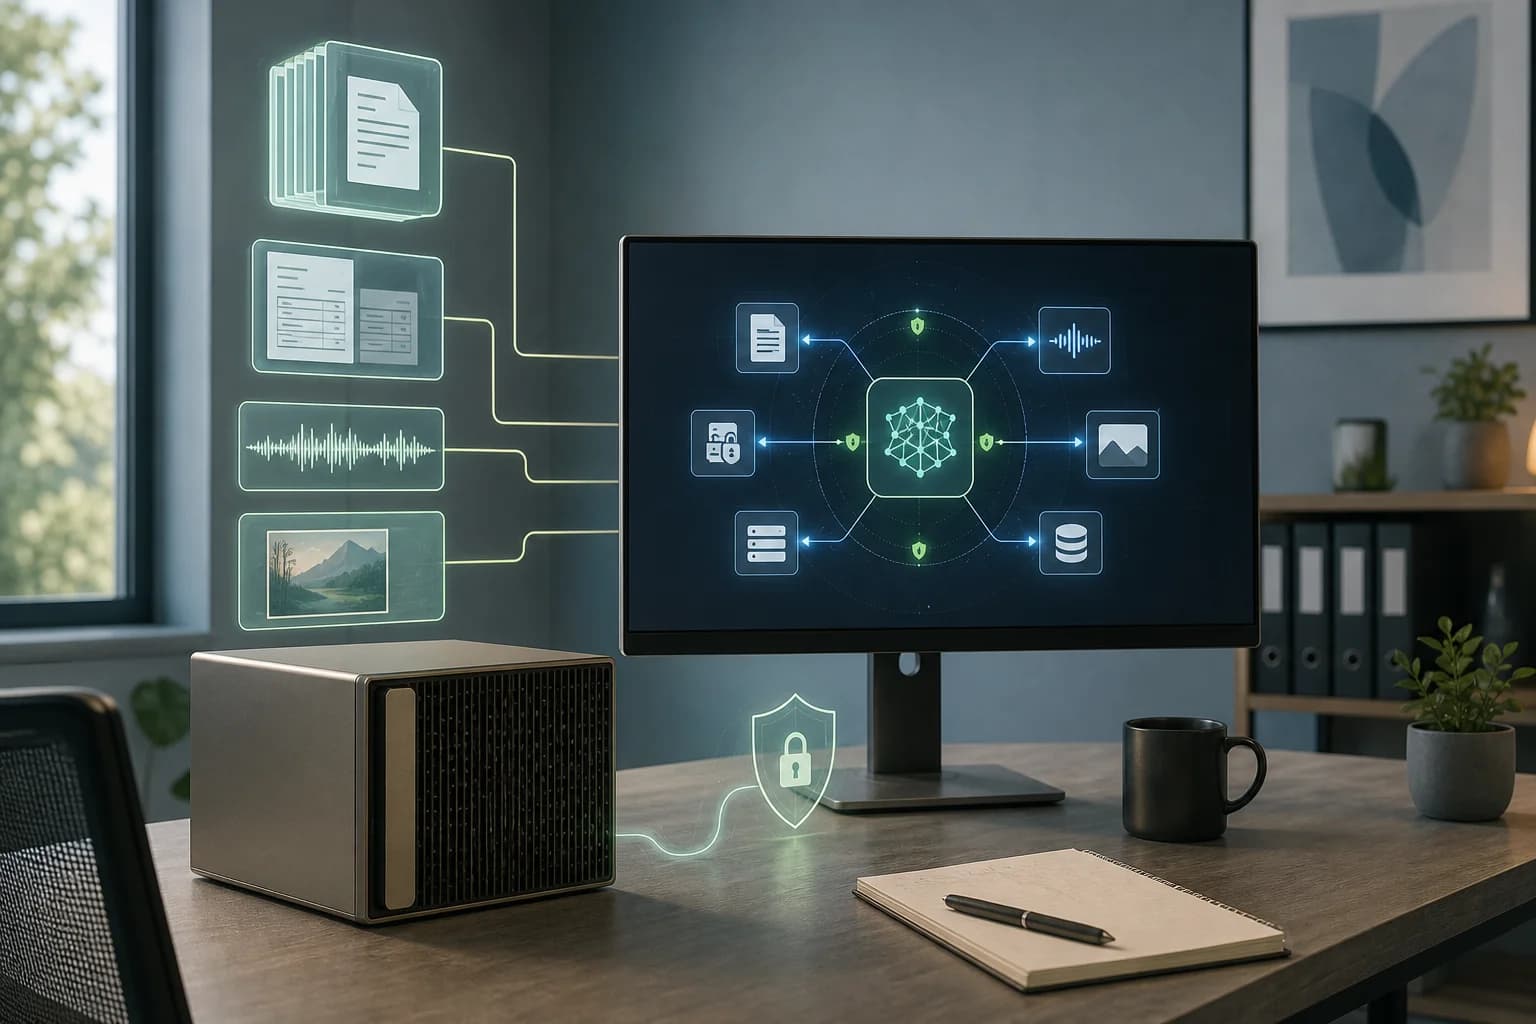
n8n راهاندازی هوش مصنوعی محلی روی NVIDIA DGX Spark را تشریح کرده است؛ رویکردی که اجرای گردشکارهای هوش مصنوعی را بدون فرستادن داده به APIهای ابری ممکن میکند. کسبوکارها میتوانند تماسها را پیادهسازی، فاکتورها را بخوانند، اسناد داخلی را جستوجو و پاسخها را بهصورت محلی آماده کنند.
این راهکار برای مجموعههایی مانند درمانگاهها، دفترهای حقوقی و حسابداری اهمیت دارد که بهدلیل قرارداد، مقررات یا تعهد حرفهای باید داده مشتری را تحت کنترل خود نگه دارند. اجرای مدل روی سختافزار سازمان، محل پردازش داده را برای ممیزی نیز شفاف میکند.
DGX Spark با ۱۲۸ گیگابایت حافظه یکپارچه CPU و GPU، میتواند چند مدل را همزمان در حافظه نگه دارد. n8n مدل Qwen3.6-35B-A3B را برای وظایف متنی پیشنهاد میکند؛ این مدل در آزمایش نویسنده برای یک کاربر ۱۲۰ و در مجموع هشت کاربر ۳۵۹ توکن بر ثانیه تولید کرد.
مدلها از طریق یک نقطه پایانی سازگار با OpenAI و با LiteLLM در اختیار نودهای OpenAI در n8n قرار میگیرند. برای پیادهسازی چنین جریانهایی، سرویس اتوماسیون با n8n میتواند مسیر اتصال فرایندهای کسبوکار به مدلهای محلی باشد.
n8n تأکید میکند مدلها و کانتینرها باید با نسخه و کامیت مشخص قفل شوند تا تغییرات بالادستی، وزن مدل یا مجوز آن را تغییر ندهد. همه مدلهای این پشته نیز مجوز استفاده تجاری دارند؛ با بارگذاری هفت مدل، دستگاه ۱۰۸ گیگابایت حافظه مصرف کرده و ۱۳ گیگابایت آزاد داشته است.
منبع: n8n Blog
پروژهای در این زمینه دارید؟
مشاورهی اولیه و برآورد هزینه رایگان است.